
Comment prendre en compte l’exposition en Machine Learning ?
Encore aujourd’hui, une forte majorité d’acteurs utilise des méthodes GLM ou GAM. Les méthodes de Machine Learning réputées pour leur performance et leur adaptabilité concurrencent les méthodes GLM et GAM. Cependant, en Machine Learning, la question de la prise en compte de l’exposition est rarement traitée, alors que celle-ci a un impact majeur dans ces modélisations. Aussi, en fonction des méthodes, l’exposition ne s’introduit pas de la même façon.
Pourquoi utiliser un offset en GLM ?
Un offset (exposition) est une variable dont le coefficient est arbitrairement fixé à 1 dans les modèles GLM.
Très utilisé dans les modèles GLM log-poisson pour son interprétabilité, son enjeu est de pondérer par rapport à la durée de couverture d’un contrat pour mettre au même niveau les différentes observations. Par exemple, d’un point de vue tarification, cela permet de prendre en compte des individus dont la durée dans le portefeuille diffère ou bien de faire des modèles sur des nombres d’individus différents d’une ligne à l’autre. L’objectif est donc d’ajouter une information importante avec un effet fixe modifiant l’espérance mais aussi la variance. Cependant le cadre statistique et l’utilisation de coefficients disparaissent ou se complexifient lors de l’utilisation par exemple de méthodes Deep Learning ou Random Forest.
En tarification, pour un usage pratique, les assureurs doivent vérifier que les primes proposées sont annuelles. Ainsi en fixant l’exposition à une année, lors de la souscription, la prime proposée correspond à une couverture d’une année entière. Il est nécessaire de conserver cette commodité.
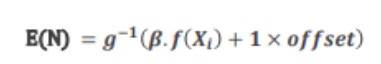
Les arbres CART ou forêt aléatoire
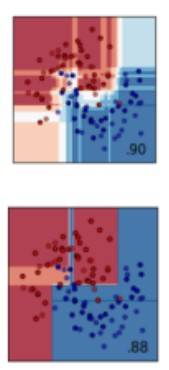
Un arbre de décision CART (Classification and Regression Tree) est une méthode de construction d’arbres de décision utilisée pour la classification et la régression. L’algorithme CART construit l’arbre en divisant récursivement les données en sous-ensembles homogènes en fonction de la variable cible. D’autre part, Une forêt aléatoire (Random Forest) est un ensemble d’arbres de décision construits sur des sous-échantillons aléatoires des données d’entraînement.
L’exposition en tant que variable dans un modèle CART ou un Random Forest ne permet que difficilement son utilisation en tant qu’offset. En effet, certaines variables pourraient être corrélées à l’exposition et conduire ainsi à une interprétation de l’offset différente de celle attendue(linéaire).
De plus, utiliser des poids n’est pas approprié lorsque l’on a un offset dans le modèle. Cela peut parfois ressembler à une régression des moindres carrés pondérés (WLS), mais ce n’est pas toujours adapté. Transformer la variable de réponse est une solution simple, mais elle n’est efficace que lorsque la variance des expositions est faible. Si la variance est élevée, cette transformation peut fortement biaiser les résultats.
Pour approfondir votre compréhension de la prise en compte de l’exposition dans les réseaux de neurones et les machines à gradient boosting, nous vous invitons à télécharger notre PDF détaillé. Ce document explore les techniques avancées et les meilleures pratiques pour intégrer l’exposition dans ces modèles de machine learning, en mettant en lumière des cas d’utilisation concrets et des stratégies d’optimisation. Téléchargez-le maintenant pour découvrir comment maximiser la précision et l’efficacité de vos modèles tout en tenant compte de cette variable cruciale.